[Research] Windows Nonpaged Pool Overflow Exploit with HEVD (KR)
0. Overview
안녕하세요. Windows Kernel Pool과 Nonpaged Pool Exploit을 주제로 Hackyboiz의 첫 번째 연구글을 쓰게 된 minzu입니다.
Hackyboiz에 들어온 후, 첫 목표는 Windows Kernel의 취약점과 Exploit 방법들을 더 공부해보자 였기에 SeoPPak님과 함께 Windows Kernel 익스플로잇들을 DB화 해보는 프로젝트를 시작하게 되었습니다. Windows Kernel의 취약점을 기반으로, EoP (Elevation of Privilege)를 달성하는 방법들을 공부해 보았습니다.
저는 Windows의 취약점 중에서 Pool과 관련된 취약점을 첫 타겟으로 잡았습니다. Windows Kernel Pool Exploitation을 공부하면서 가장 먼저 이해해야 하는 요소 중 하나는 Kernel Memory Management입니다. 취약한 메모리 객체를 접근할 때 주변에 어떤 객체가 배치될 수 있는지, 취약점 트리거 이후 다른 객체들의 변화가 어떻게 일어나는지 파악해야합니다.
이번 연구글에서는 Windows 11 25H2 (26200.9711)을 기준으로 필요한 Windows Kernel Pool과 관련된 내용을 살펴보고 그 중 HEVD의 NX Nonpaged Pool Overflow 취약점을 Exploit 하는 방법에 대해서 설명해보겠습니다.
1. Windows Kernel Pool Architecture
Windows에서 User Mode와 Kernel Mode가 모두 동적으로 메모리를 할당할 수 있습니다. User Mode에서는 malloc, new, HeapAlloc 등의 함수들을 이용하여 User 영역의 Heap 공간에 User Heap Allocator가 동적할당합니다. 반면, Kernel Driver는 ExAllocatePool2, ExAllocatePool3와 같은 API를 통해 Kernel Pool 공간에 Kernel Pool Allocator가 동적할당하여 메모리를 확보합니다.
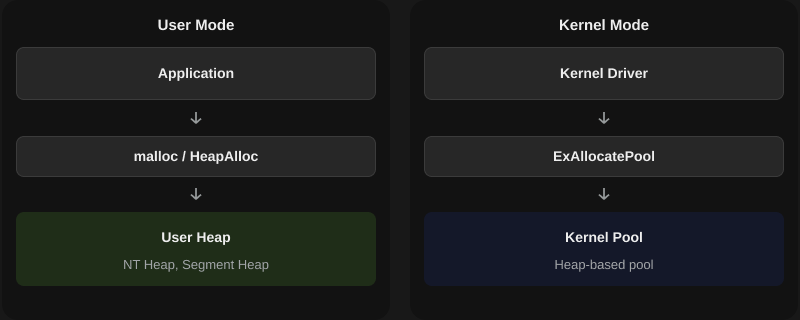
User Mode의 Heap의 할당에 대해서는 해키보이즈 블로그에 NT Heap과 Segment Heap에 대한 내용이 있으니 읽어보시면 Kernel Pool을 이해하는데 더 도움이 될 것 같습니다.
Kernel Mode에서는 드라이버가 I/O 요청을 처리할 때 사용하는 버퍼, 파일 시스템의 파일 객체 등 커널에서 동적 메모리 할당이 필요합니다. 이 필요에 따라 Kernel Pool에 메모리를 할당하는 함수 ExAllocatePool2 등의 API를 제공합니다.
과거 Windows 7 시기의 Pool Allocator는 Pool Descriptor와 크기별 Free List, _POOL_HEADER 등을 중심으로 메모리를 관리했습니다. 그러나 Windows 10 19H1 이후에는 Heap-backed Pool 구조를 사용하면서 실제 메모리 블록의 관리 방법이 달라졌습니다.
Windows 10 19H1 이후 Windows Kernel Pool의 내부 관리 방식은 전통적인 Pool Descriptor 및 Free List 중심 구조에서 Heap-backed Pool 구조로 변화했습니다. 이에 따라 같은 Pool API를 사용하더라도 요청 크기와 Heap의 내부 상태에 따라 LFH(Low Fragmentation Heap), VS(Variable Size), Segment Backend 등의 서로 다른 Allocator 경로를 사용하게 되었습니다.
1.1 Pool Allocation API
Kernel Mode의 Pool 할당은 대표적으로 ExAllocatePool2 함수를 이용합니다.
DECLSPEC_RESTRICT PVOID ExAllocatePool2(
  POOL_FLAGS Flags,
  SIZE_T     NumberOfBytes,
  ULONG      Tag
);| Parameter | |
|---|---|
Flags |
Pool 종류와 메모리 할당 속성 |
NumberOfBytes |
호출자가 요청한 바이트 수 |
Tag |
할당을 추적하기 위한 식별자 |
ExAllocatePool2는 Pool을 할당할 수 있다면, 할당된 메모리의 포인터를 반환합니다.
먼저 인자 중 POOL_FLAGS는 64비트 값으로 표현된 Pool Type에 대한 정보입니다. Pool을 할당할 때 Flags 인자를 활용하여 사용할 타입에 맞는 Pool을 할당할 수 있으며, 다양한 종류의 Pool이 64비트로 표현됩니다. 두 번째로 NumberOfBytes는 호출자에게 주는 사용 가능한 영역의 크기입니다. Pool 앞에는 _POOL_HEADER 라는 메타데이터 헤더가 붙기 때문에, Pool은 _POOL_HEADER의 크기 + NumberOfBytes 의 크기 만큼의 공간이 Pool에 할당됩니다. 이에 대한 자세한 내용은 나중에 자세히 보겠습니다. 마지막으로 Tag의 경우 Pool의 정보를 추가로 식별할 수 있는 4바이트 식별자입니다. 예를 들어, Named Pipe에서 할당한 pool은 NpFr 이라는 tag로 할당됩니다.
1.2 Pool Types
① Paged Pool & Nonpaged Pool
Kernel Pool은 메모리의 상주 여부에 따라서 Paged Pool과 Nonpaged Pool로 구분합니다.
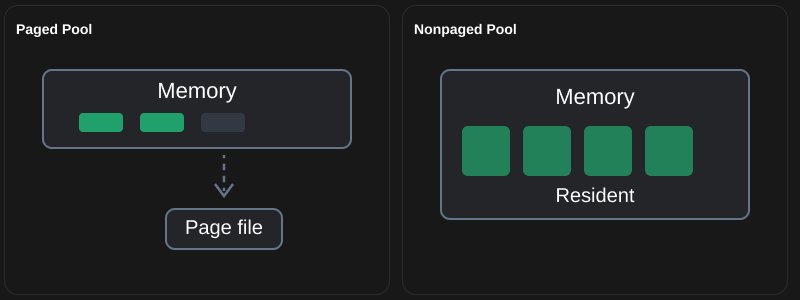
Paged Pool은 메모리 관리 정책에 따라 페이지가 물리 메모리에서 page-out 될 수 있습니다. 메모리 관리자가 필요할 때 물리 페이지의 내용을 램에서 디스크로 내보낼 수 있는 영역입니다. 즉, 페이지가 현재 물리 메모리에 존재하지 않으면 page fault가 발생하며, 운영체제는 필요한 페이지를 다시 가져옵니다.
Nonpaged Pool은 접근 시 메모리가 항상 존재해야 하는 코드에서 사용됩니다. 특히 일반적인 page fault를 처리할 수 없는 높은 IRQL의 실행 경로에서 필수적으로 필요합니다. 높은 IRQL 레벨에서는 page fault를 처리할 수 없습니다. 따라서 DISPATCH_LEVEL에서 접근해야하는 데이터는 Nonpaged Pool에 있어야합니다.
② Mitigation : NX
리눅스와 같이, NX (No-eXecute)는 해당 페이지의 데이터의 실행 권한이 없다는 mitigation입니다. PTE의 63번 비트가 1이면 NX가 활성화 되어있다는 의미입니다.
Windows에서 Pool의 할당을 요청할 때, ExAllocatePool2 함수를 주로 사용합니다. 해당 함수의 첫 번째 인자는 Pool의 속성을 나타내는 플래그입니다. Windows에서 POOL_FLAG_NON_PAGED 플래그를 이용한 Allocation은 NX Nonpaged Pool을 요청합니다. NX mitigation이 없는 Nonpaged Pool을 요청하려면 POOL_FLAG_NON_PAGED_EXECUTE플래그를 사용해야 합니다. 즉, 같은 Nonpaged Pool이어도, NX의 여부를 선택할 수 있습니다.
예를 들어, NX mitigation이 있는 Pool과 NX mitigation이 없는 Pool에 동적 메모리를 할당합니다.
// NX Nonpaged Pool
PTE = 8A0000009183E963

// Executable Nonpaged Pool
PTE = 0A0000004D471963
WinDbg로 해당 Pool의 PTE를 확인해보면, PTE의 최상위 비트가 NX가 적용했을 때만 1인것을 확인할 수 있습니다.
2. HEVD Nonpaged Pool Overflow Vulnerability
2.1 Root Cause
이번 exploit에서 살펴볼 취약점은 BufferOverflowNonPagedPoolNx 입니다. HEVD는 의도적으로 취약한 커널 드라이버로, 해당 함수는 NX가 적용된 Nonpaged Pool에 overflow가 발생하는 코드입니다.
KernelBuffer = ExAllocatePoolWithTag(
    NonPagedPoolNx,
    0x1F0,
    'kcaH'
);

ProbeForRead(UserBuffer, 0x1F0, 1);

RtlCopyMemory(
    KernelBuffer,
    UserBuffer,
    InputBufferLength
);
취약점은 다음과 같습니다. 커널이0x1F0 크기의 Nonpaged Pool을 할당합니다. 하지만, RtlCopyMemory에서는 할당된 버퍼의 크기인 0x1F0이 아닌InputBufferLength를 사용합니다.
ProbeForRead는 사용자 버퍼가 지정한 범위에서 읽기 가능한지 검사하기 위한 함수입니다. 해당 함수는 버퍼의 접근 가능 여부를 확인할 뿐, 복사 대상인 KernelBuffer의 크기를 검증하지 않습니다. 이 코드에서는 KernelBuffer를 0x1F0바이트로 할당했지만, RtlCopyMemory()는 별도의 InputBufferLength 값을 복사 크기로 사용합니다. 따라서 InputBufferLength가 0x1F0을 초과하면 Overflow가 발생합니다.
이 취약한 커널 Pool은 ‘Hack’ 이라는 태그로 할당됩니다. 앞으로는 ‘Hack’이라는 태그로 취약한 버퍼를 명시하겠습니다.
2.2 Flow
위에서 언급했던 것처럼 어떤 타입의 Pool에 Allocate 되느냐도 중요하지만, 어떤 Allocator가 할당하는지도 중요합니다. HEVD는 ExAllocatePoolWithTag 함수를 통해 호출합니다. 예전 Pool할당 함수이기 때문에 내부적으로 현대의 Windows 11에서는 ExAllocatePool2로 연결됩니다. 실제로 최근 Windows에서 Pool Allocate 함수를 직접 확인해보면 아래와 같은 흐름으로 확인됩니다.
ExAllocatePoolWithTag
    ↓
ExAllocatePool2
    ↓
ExpAllocatePoolWithTagFromNode
    ↓
ExAllocateHeapPool
    ↓
RtlpHpVsContextAllocate
호출을 확인해보면, 25H2 환경에서는 VS Allocator를 사용합니다.
Pool에 대한 내용들과, HEVD의 exploit 레퍼런스에 따르면, 0x1F0 바이트 크기의 Pool은 LFH Allocator로 할당됩니다. 대부분 0x200 크기를 기준으로 LFH, VS Allocator가 나눠집니다. 24H2에서는, LFH Allocator로 할당되었습니다. 하지만, 25H2에서는 0x1F0 바이트를 할당했을 때, Pool Header가 인지하는 BlockSize 변수가 0x200이 되면서, 해당 Pool을 0x200 바이트로 인지하여 VS Allocator가 할당합니다. 이때 중요한 점은 동적 메모리 영역의 크기가 0x200이 되는 것은 아니라는 점입니다. 그저 내부 함수가 분기할 때 인지하는 바이트의 크기가 0x200인 것입니다. 이는 LFH bucket의 활성화 여부, alignment 등과 같은 환경에 의해 달라질 수도 있습니다.
따라서, 이번 연구글에서는 해당 크기의 Pool이 VS Allocator로 할당된다는 것을 전제로 진행하겠습니다!
3. Kernel Pool Allocator Internals
앞에서는 Windows Kernel Pool의 기본 개념과 Pool Allocation API를 기반으로 HEVD에서 어떻게 Pool을 할당하는지 간단하게 살펴보았습니다. 이를 자세히 이해하기 위해서는 Allocator에 대한 이해가 필요합니다. LFH와 VS를 이해하기 위해서 간단하게 Kernel Pool Allocator에 대해 살펴보도록 하겠습니다.
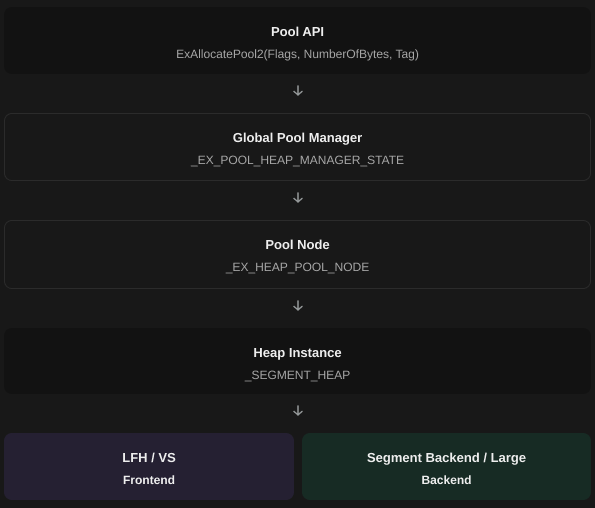
드라이버가 ExAllocatePool2를 호출하면, Windows는 적절한 Pool을 선택해야합니다. 어떤 요청은 LFH의 slot을, 어떤 요청은 VS의 Chunk를 사용할 수도 있고 메모리가 더 커지면 Segment Backend에서 페이지 범위를 직접 확보하거나 별도의 Large Allocation 경로를 사용할 수도 있습니다. 이번 글에서는 VS에 대해서 살펴보겠습니다.
3.1 LFH와 VS의 차이
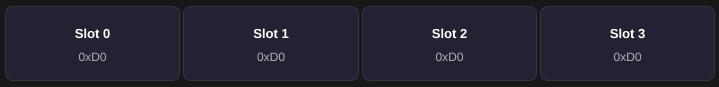
LFH (Low Fragmentation Heap)는 동일한 Size Class에 속하는 메모리를 고정 크기의 Slot으로 관리합니다. 예를 들어 한 LFH Subsegment에서 Slot크기가 0xD0라면, 각 Slot은 일정한 간격으로 배치됩니다.
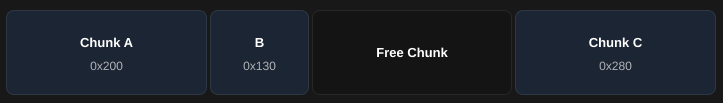
VS (Variable Size)는 서로 다른 크기의 Chunk를 관리합니다. 하나의 VS Subsegment에는 크기가 다른 Chunk들이 존재할 수 있으므로, 다음 Chunk의 위치를 알아내려면 현재 Chunk의 크기와 상태를 확인해야 합니다.
이것이 두 Allocator의 가장 중요한 차이입니다. VS Allocator는 크기가 다른 Chunk를 관리하기 위해 _HEAP_VS_CHUNK_HEADER에 개별 Chunk의 크기와 상태 정보를 저장합니다. 또한 크기가 서로 다른 Free Chunk들을 빠르게 찾기 위한 FreeChunkTree도 사용합니다.
3.2 VS의 구조
VS 전체 상태 관리는 _HEAP_VS_CONTEXT에서 시작합니다. Windows 11 25H2를 기준으로, _SEGMENT_HEAP에서는 VsContext가 +0x2C0에 존재합니다. 아래와 같은 구조들을 사용해서 VS는 상태를 관리합니다.
| Structure | |
|---|---|
_HEAP_VS_CONTEXT |
VS 전체 설정과 Affinity 관련 관리 |
_HEAP_VS_AFFINITY_SLOT |
FreeChunkTree, SubsegmentList, Delayed Free |
_HEAP_VS_SUBSEGMENT |
실제 Chunk들이 존재하는 메모리 범위 |
_HEAP_VS_CHUNK_HEADER |
개별 Chunk의 크기와 상태 |
_HEAP_VS_CHUNK_FREE_HEADER |
Free Chunk의 Tree 관리 정보 |
이러한 구조들을 통해 VS는 새로운 요청에 적합한 Free Chunk를 찾고, 조건에 따라 큰 Chunk를 분할하거나 인접한 Free Chunk를 병합하기도 합니다.
이 구조에서 Exploit과 직접적으로 관련되는 것은 VS Chunk Header입니다. VS가 Chunk의 크기와 상태를 관리하기 위해 사용하는 메타데이터이므로, Overflow가 해당 Header를 손상시키면 이후 Free나 재사용 과정에 영향을 줄 수 있습니다.
3.3 HEVD Pool Allocate
VS가 관리하는 Pool Allocation에서는 Pool Header 앞에 VS Chunk Header가 존재할 수 있습니다. HEVD의 Pool Allocation을 디버깅해보면, 아래와 같은 구조를 확인할 수 있습니다.
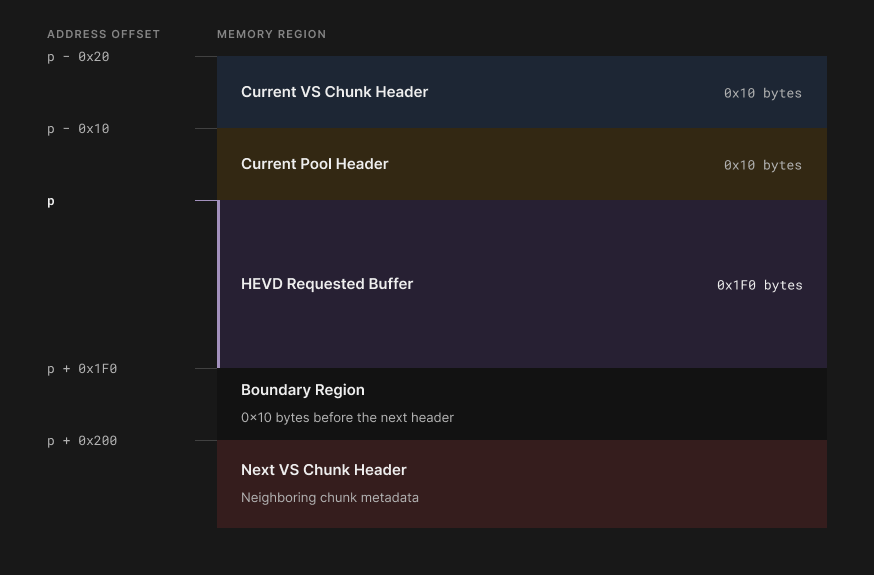
할당된 Pool의 주소를 P라고 하고 WinDbg로 디버깅해보면 위와 같은 결과를 확인할 수 있습니다. 여기서 Pool Header에는 Pool을 할당할 때 사용한 Hack 태그와 BlockSize=0x20이 나타납니다. 이때, x64환경에서 BlockSize 변수는 0x10바이트 단위입니다. 즉, 취약한 커널 Pool 자체는 0x1F0가 할당되었지만, Pool Header는 0x200바이트로 관리하게 됩니다. Heap-backed Pool의 다양한 자료들에 따르면, 0x200 크기부터 VS에서 관리합니다. 할당하고자 하는 동적 메모리가 0x200 이하이기 때문에 당연히 Allocation이 LFH에서 이루어진다는 것은 보장할 수 없다는 것을 확인할 수 있죠.
직접 25H2 환경에서 드라이버를 만들어서 확인해본 결과, Nonpaged Pool의 0x1f0 할당은 100회 이상 반복해도 VS Allocator 경로로 분기합니다. 즉, 애초에 Pool이 인지할 때 0x200으로 인지하기 때문에 VS Allocator의 분기로 가게 되며, LFH Allocator로 가지 않습니다.
결과적으로 HEVD가 요청한 데이터의 크기는 0x1F0이지만, Windows 11의 Frontend Allocation에서는 0x10바이트가 추가되어 분기합니다. 따라서 Pool Header는 해당 Pool의 크기를 0x200으로 인식하고 VS Allocator를 사용하게 됩니다.
4. Exploit
앞에서는 HEVD의 NX Nonpaged Pool Overflow 취약점과 VS Allocator의 메모리 관리 구조를 살펴보았습니다. 이제 이러한 메모리 구조를 바탕으로 Pool Overflow가 Named Pipe 객체에 어떤 영향을 주는지 분석하고, 이를 Arbitrary Address Read/Write 및 권한 상승으로 확장하는 과정을 살펴보겠습니다.
익스플로잇의 순서는 다음과 같습니다.
- Pool Grooming
- Pool Overflow
- Named Pipe Metadata Corruption
- Arbitrary Address Read
- Arbitrary Address Write
- Token Swapping
- Cleanup
4.1 Pool Grooming
HEVD는 0x1F0 바이트의 Nonpaged Pool을 할당합니다. 그러나 Buffer Overflow가 발생하더라도 해당 버퍼 바로 뒤에 어떤 객체가 배치되는지는 알 수 없습니다. 따라서, Nonpaged Pool에 원하는 객체가 overflow로 인해 영향을 받도록 미리 배치해두는 과정이 필요합니다. 즉, 원하는 객체들 주변에 취약한 객체가 위치하도록 하는 것입니다.
Nonpaged Pool에 exploit에 주로 사용하는 객체는 Named Pipe입니다. Named Pipe에 대한 자세한 내용은 해키보이즈 글을 참고해주세요!
Windows 커널의 NPFS(Named Pipe File System)는 파이프를 통해 전달되는 데이터를 내부 Queue로 관리하며, 이 과정에서 NP_DATA_QUEUE_ENTRY와 같은 자료구조를 사용합니다. 이러한 DQE는 데이터 저장 방식에 따라 Buffered Entry와 Unbuffered Entry로 구분합니다.
- Buffered DQE : data가 DQE Header 바로 뒤에 이어집니다.
- Unbuffered DQE : data가
IRP->AssociatedIrp.SystemBuffer에 존재합니다.
Buffered DQE를 이용하여 원하는 공간에 취약한 객체를 할당하는 Pool Grooming에 대해 살펴보겠습니다.
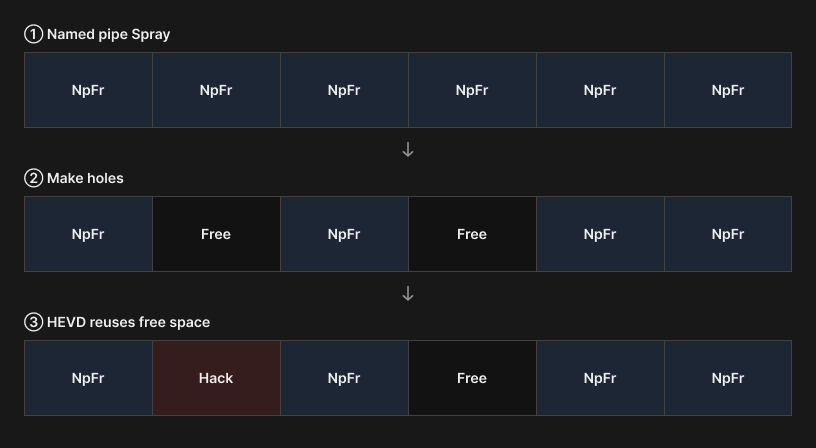
위 그림이 Pool Grooming의 순서입니다. 먼저 취약한 객체와 같은 크기의 구멍을 만들기 위해 같은 크기의 객체들을 spray 합니다. Buffered DQE의 Header 크기는 0x30바이트입니다. 따라서 Named Pipe에 0x1C0바이트의 데이터를 기록하면, DQE Header와 데이터를 합한 크기는 0x1F0바이트가 됩니다. 이는 HEVD가 요청하는 0x1F0바이트와 동일한 크기입니다
이와 같이 Named Pipe를 spray 한 뒤, 중간 중간 만들어준 Named Pipe 객체를 free하면서 hole을 만듭니다. 이렇게 해제하면, VS의 Free Chunk 상태를 변화시킬 수 있습니다. Named Pipe 객체를 다수 할당한 후 일부 객체를 해제하면 해당 메모리 영역을 재사용할 수 있는 상태가 만들어집니다. 이러한 Pool Grooming은 HEVD의 취약한 버퍼가 Named Pipe 객체와 인접한 위치에 할당될 가능성을 높일 수 있습니다.
4.2 Pool Overflow
RtlCopyMemory에서는 할당된 버퍼의 크기인 0x1F0이 아닌, 별도로 전달된 InputBufferLength를 사용하면서 취약점이 발생했습니다. 해당 exploit에서는 0x23C를 InputBufferLength로 설정하여 0x4C의 overflow로 exploit을 진행하겠습니다.
Pool Grooming을 통해 HEVD Buffer와 Named Pipe 객체가 인접하게 배치되었다고 가정하면, 아래와 같은 메모리 레이아웃에서 Buffer Overflow가 발생합니다.
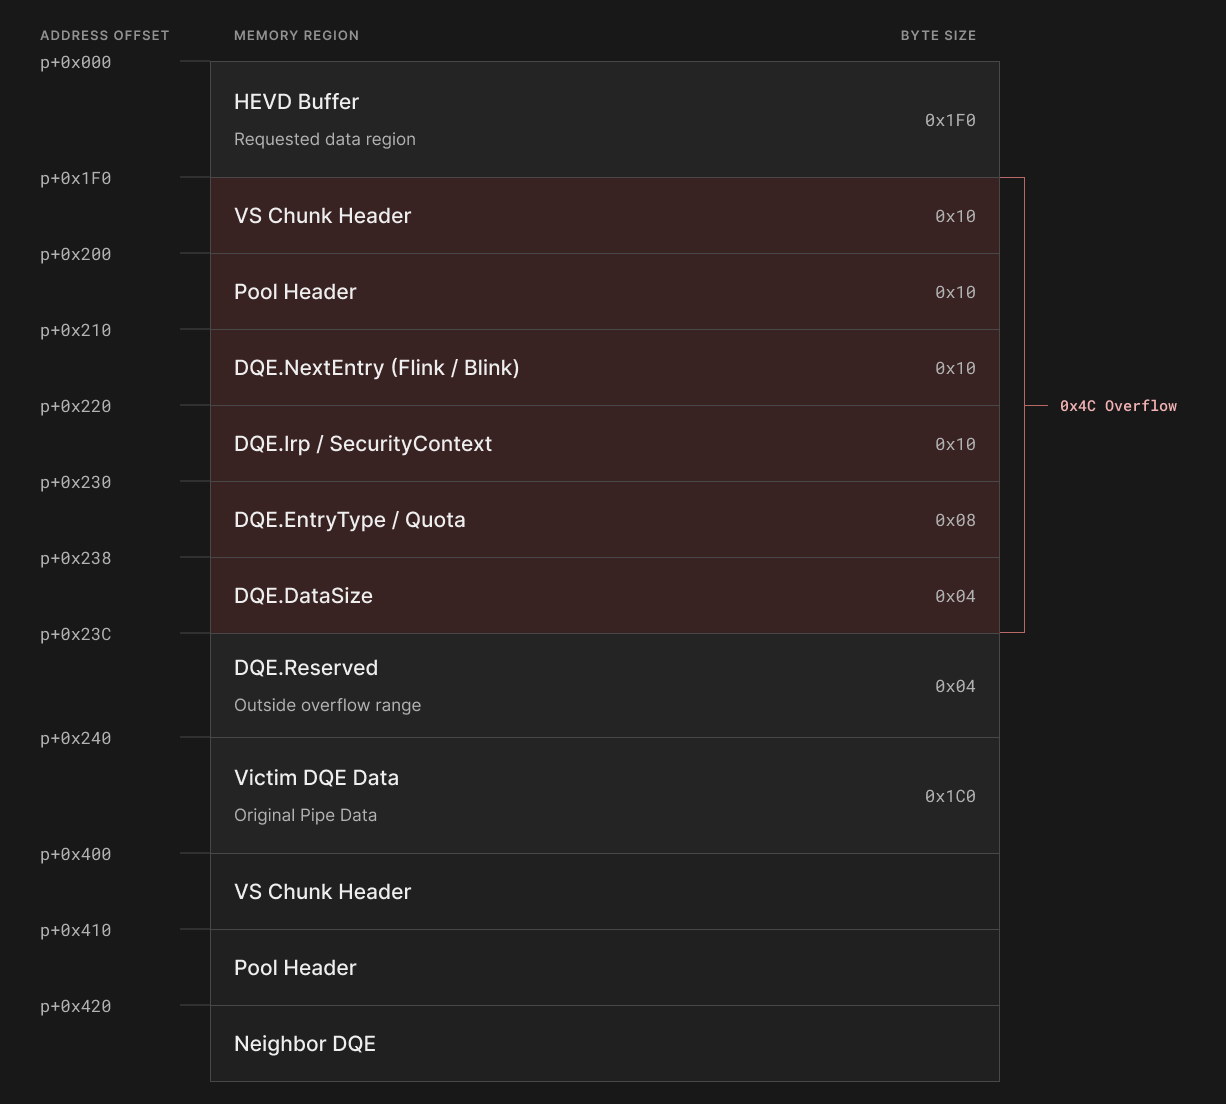
위 구조에서 볼 수 있듯이 0x4C만큼의 Overflow가 발생하면, DQE Header의 DataSize까지 덮을 수 있습니다. 앞으로는 이렇게 영향을 받은 DQE를 Victim DQE라고 부르겠습니다.
4.3 Named Pipe Metadata Corruption
Overflow 이후에는 위 스택 그림에서 보듯이 Victim DQE의 Header를 수정할 수 있습니다. exploit을 위해 Victim DQE Header의 DataSize는 원래 0x1C0이었지만, overflow를 이용하여 DQE Header의 DataSize를 0x200으로 변경하겠습니다. Victim DQE의 DataSize 필드는 해당 Queue Entry가 관리하는 데이터 길이를 나타냅니다. 이 값이 실제 저장된 데이터 크기보다 크게 손상되면, NPFS가 손상된 길이 정보를 바탕으로 데이터를 처리하는 과정에서 원래 데이터 영역을 넘어 메모리에 접근할 수 있습니다. 여기에서 PeekNamedPipe함수를 실행하면, DQE의 관리 정보에 따라 변경된 길이만큼 읽을 수 있게 되고, 기존 데이터 뒤에 위치한 메모리까지 반환합니다.
PeekNamedPipe()는 Named Pipe에 저장된 데이터를 소비하지 않고 조회하는 Windows API입니다. 이 사례처럼 DQE의 길이 정보가 손상되면 Named Pipe 객체가 실제 데이터 범위를 넘어 메모리를 복사하는 현상이 발생하기도 합니다.
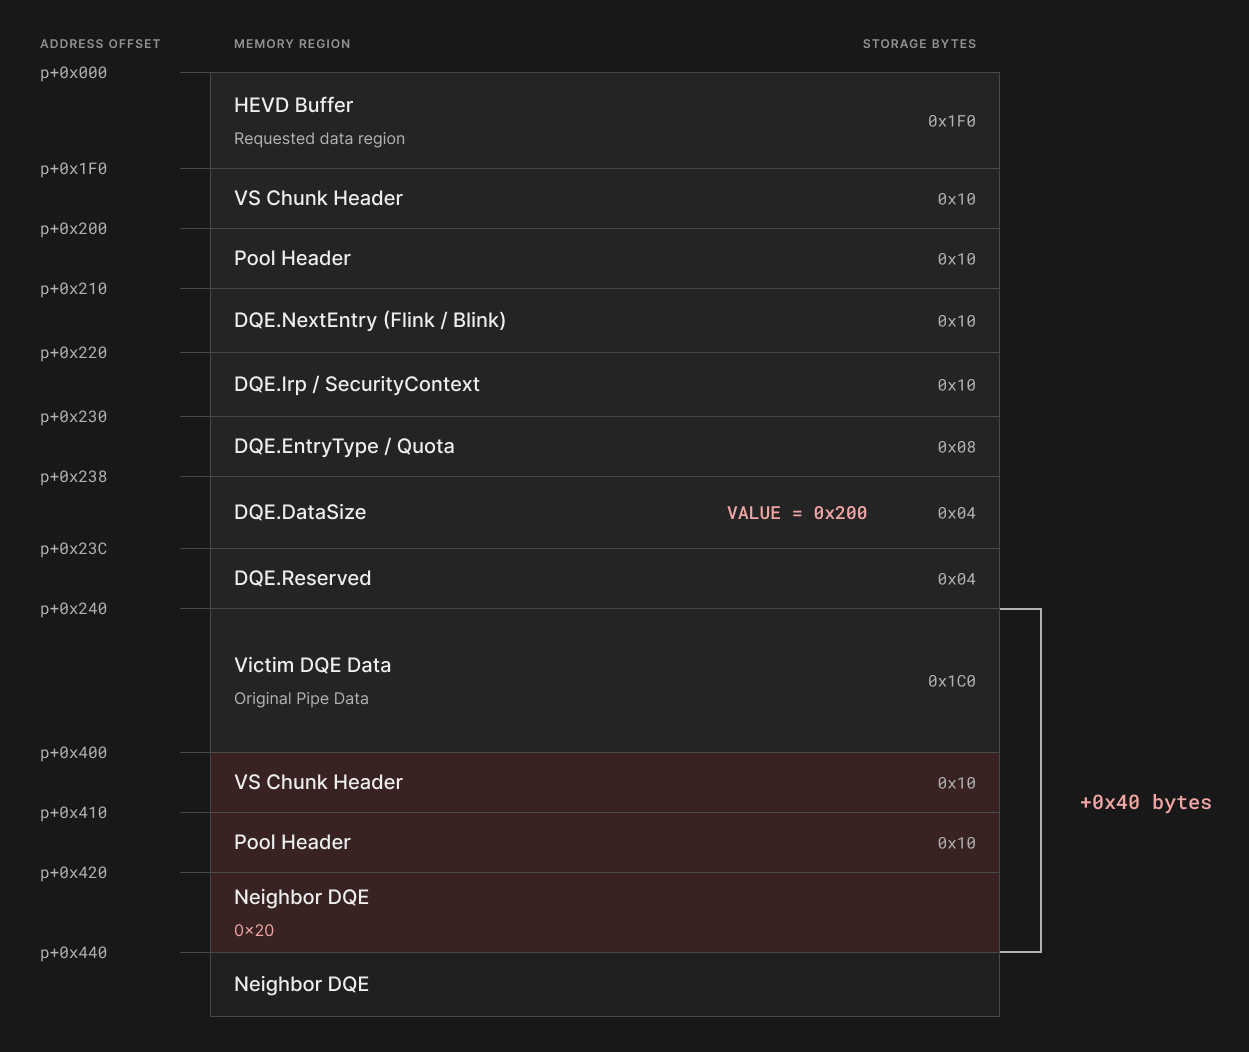
Victim DQE의 DataSize가 기존 0x1C0에서 0x200으로 증가하면, 기존 데이터 영역보다 0x40바이트 더 큰 범위를 읽을 수 있습니다. 이때 읽는 Neighbor DQE는 Victim DQE의 NextEntry에 연결된 Queue에서 다음 DQE가 아닌, 물리적으로 붙어있는 DQE입니다. 이 과정에서 Neighbor DQE의 Header 정보를 확인할 수는 있지만, 원하는 주소를 읽거나 쓰는 AAR/AAW를 구현할 수는 없습니다.
4.4 Arbitrary Address Read (AAR)
앞에서 확보한 것은 Victim DQE의 데이터 영역을 넘어 0x40바이트를 읽을 수 있는 Information Disclosure입니다. 이제 이 Information Disclosure를 확장하여 원하는 주소의 데이터를 읽는 AAR로 확장해보겠습니다!
여기서 반드시 구분해야할 두 가지가 있습니다.
- 연속된 메모리 공간에서의 DQE
- 다음 DQE : NextEntry가 가리키는 DQE
NPFS는 DQE들을 논리적인 Queue 형태로 관리하며, DQE의 NextEntry는 일반적으로 LIST_ENTRY 형태의 연결 정보를 포함합니다. 이 구조에서 Flink는 다음 Entry를, Blink는 이전 Entry를 가리킵니다. 중요한 점은 이러한 Queue의 순서가 실제 메모리 주소의 순서와 반드시 일치하지 않는다는 것입니다. 따라서 메모리상 인접한 DQE와 연결 리스트에서 다음 Entry로 지정된 DQE는 서로 다른 객체일 수 있습니다.
그 전에, Named Pipe의 데이터가 Queue에 저장될 때 어떻게 저장되는지 살펴보고 PeekNamedPipe() 함수가 어떻게 동작하는지 살펴보겠습니다. 아까 확인했듯이 이 API 함수는 DQE 정보를 바탕으로 data를 읽어 반환하는 함수입니다. 하지만, 만약 요청한 데이터의 크기가 pipe에 있는 데이터 크기보다 크다면, 다음 DQE에서 남은 byte 수만큼 읽어옵니다.
예를 들어, 아래와 같이 pipe에 두 번의 WriteFile()을 수행했다고 가정하겠습니다. WriteFile()은 지정된 파이프에 데이터를 기록하는 Windows API입니다. NPFS는 파이프의 상태와 버퍼링 방식에 따라 해당 데이터를 내부 DQE로 관리할 수 있으며, 이번 실험에서는 Buffered DQE가 생성되는 경로를 사용합니다.
WriteFile(pipe, "AAAA", 4, ...);
WriteFile(pipe, "BBBB", 4, ...);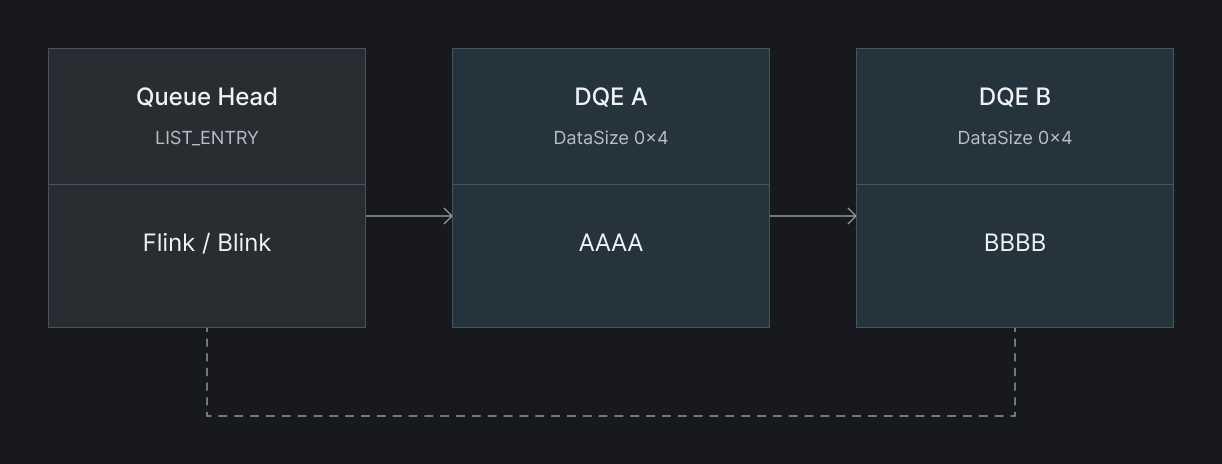
이 때 PeekNamedPipe()함수로 8byte를 조회하면, DQE A의 4바이트를 먼저 복사하고, 출력 버퍼에 아직 4바이트가 남아있기 때문에 다음 DQE B로 넘어가서 복사하여 출력버퍼에 넣습니다. 그러면 PeekNamedPipe() 함수는 AAAABBBB를 출력합니다.
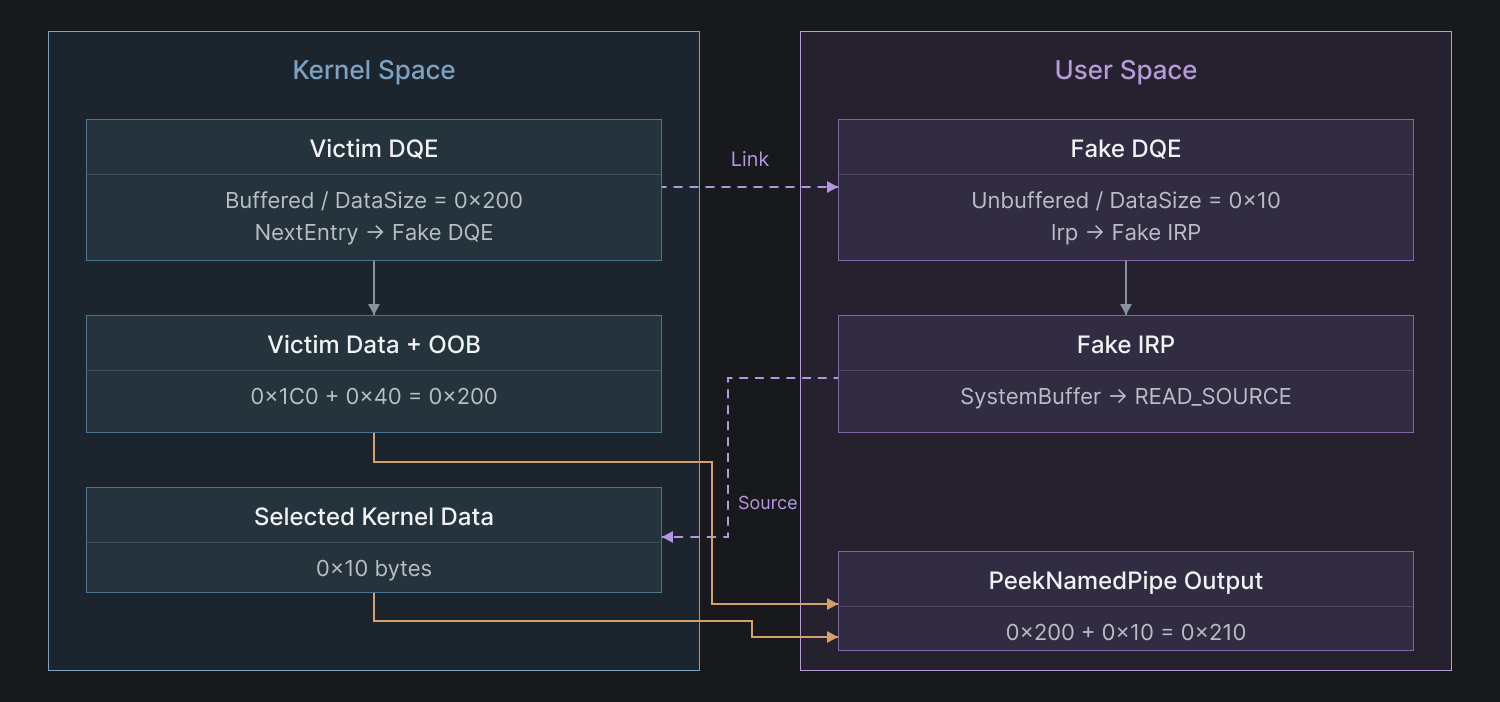
지금 Information Disclosure가 발생한 상태의 Pool의 메모리 배치와 구조는 다음과 같습니다.
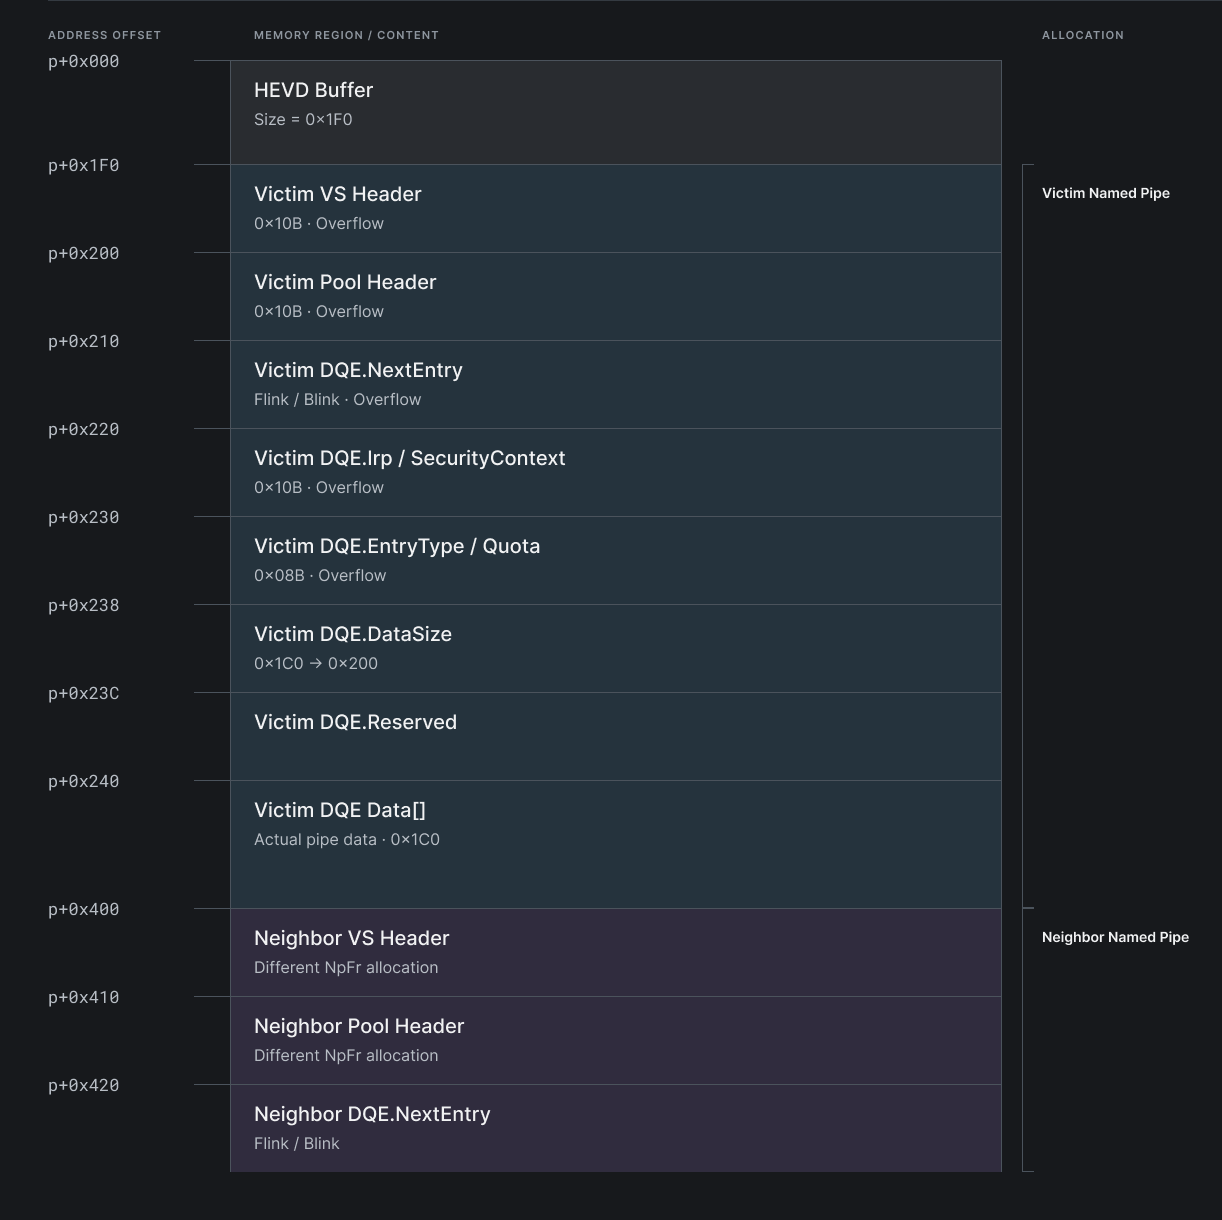
이 Pool 구조 배치에서 AAR을 얻기 위한 과정을 진행해보도록 하겠습니다.
FakeDQE.EntryType = UNBUFFERED;
FakeDQE.Irp       = FakeIRP;
FakeDQE.DataSize  = READ_LENGTH;

FakeIRP.AssociatedIrp.SystemBuffer = READ_SOURCE;
Fake DQE를 만들어 Victim DQE.NextEntry에 연결해주면, 임의 주소를 선택해서 읽을 수 있습니다. Fake DQE는 DQE와 구조가 같게 만듭니다. 다만, Unbuffered DQE로 만들고 Fake IRP를 만들어, AssociatedIrp.SystemBuffer에 읽을 data의 주소를 넣습니다. 이렇게 DQE의 data를 저장합니다. Unbuffered DQE를 사용하는 이유는 Fake DQE를 만들 때 data를 포함한 DQE가 아니라, IRP->AssociatedIrp.SystemBuffer의 주소만 바꿈으로써 좀 더 쉽게 데이터를 처리할 수 있기 때문입니다.
uint8_t buffer[0x210]{};

BOOL ok = PeekNamedPipe(
    pipe, buffer, sizeof(buffer),
    &bytesRead, &available, nullptr
);

if (!ok || bytesRead != 0x210)
    return false;

uint64_t value = 0;
memcpy(&value, buffer + 0x200, sizeof(value));
따라서 0x210바이트에 대해서 PeekNamedPipe() 함수를 호출하게 되면 Victim DQE의 DataSize인 0x200을 읽은 후에도 출력 버퍼가 남기 때문에, 다음 DQE에서 0x10을 읽어오게 됩니다. 이때 다음 DQE에서 0x10을 읽어오는 값은 Fake DQE에 연결된 Fake IRP의IRP->AssociatedIrp.SystemBuffer입니다.
즉, Overflow가 Trigger될 때 Victim DQE의 DataSize, NextEntry를 조작함으로써 해당 과정이 이루어지고 추가 Fake DQE, Fake IRP로 원하는 주소의 Read 작업이 이루어질 수 있습니다.
4.5 Arbitrary Address Write (AAW)
AAR에서는 Named Pipe에서 값을 읽어 사용자 버퍼로 반환했습니다. AAW에서는 데이터 이동의 방향을 바꾼다고 생각하면 편합니다. AAR은 Fake DQE에서 데이터를 가져오는 과정이었다면, 이번에는 데이터를 Fake DQE에 쓰는 것이 AAW로 이어집니다. 이러한 과정을 준비하기 위해서는 우리가 조작하고 싶은 위치 정보를 가진 Fake DQE와 Fake IRP가 필요합니다.
먼저, Fake IRP 구성을 위해 Helper Pipe와 Pending IRP 처리를 이용하겠습니다.
앞선 Overflow 과정에서 Victim Pipe의 DQE 메타데이터와 Queue 연결 관계가 손상되었습니다. 이후 AAW 과정을 분석하기 위해서는 기존 Victim Pipe와 별개로 추가적인 객체를 준비할 필요가 있습니다. 이를 위해 별도의 Named Pipe를 생성하고 이를 Helper Pipe라고 부르겠습니다. Helper Pipe는 AAW 분석에 필요한 IRP 및 관련 I/O 상태를 준비하는 데 사용합니다.
IRP는 I/O 요청을 처리하는 커널 객체입니다. 만약 파이프가 더 이상 데이터를 즉시 받아들일 수 없는 상태에서 추가 Write 요청이 발생하면, 관련 I/O 요청이 Pending 상태로 남습니다. 이 exploit에서는 Helper Pipe에 0x1C0의 data 크기를 가진 Buffered DQE를 생성하고 0x2000바이트의 Overlapped Write를 요청합니다. 이렇게 되면, 이 0x2000바이트 Write의 IRP 요청이 Pending 상태에 놓이게 됩니다. 즉, 이렇게 IRP 요청을 Pending 상태로 유지하면 WriteFile()과 관련된 IRP를 확보할 수 있게 됩니다. AAR을 사용해서 이 IRP의 구조와 크기, 관리 필드등을 읽어와 실제 사용하는 IRP를 복구할 수 있습니다. 이 Fake IRP를 NtFsControlFile()의 InputBuffer로 전달합니다.
NtFsControlFile()은 파일 시스템이나 파일 시스템 필터에 FSCTL 요청을 전달하는 시스템 서비스입니다. 실제로 어떤 I/O 객체와 Queue Entry가 생성되는지는 요청에 사용한 FSCTL과 NPFS 내부 처리 경로에 따라 달라집니다. 이때, METHOD_BUFFERED 방식을 사용합니다. Windows의 Buffered I/O 에서는 IRP의 AssociatedIrp.SystemBuffer가 데이터를 나타냅니다. 결과적으로 Fake IRP를 InputBuffer로 전달하면 AssociatedIrp.SystemBuffer 에 제가 만든 Fake IRP가 존재하는 구조를 가지게 됩니다.
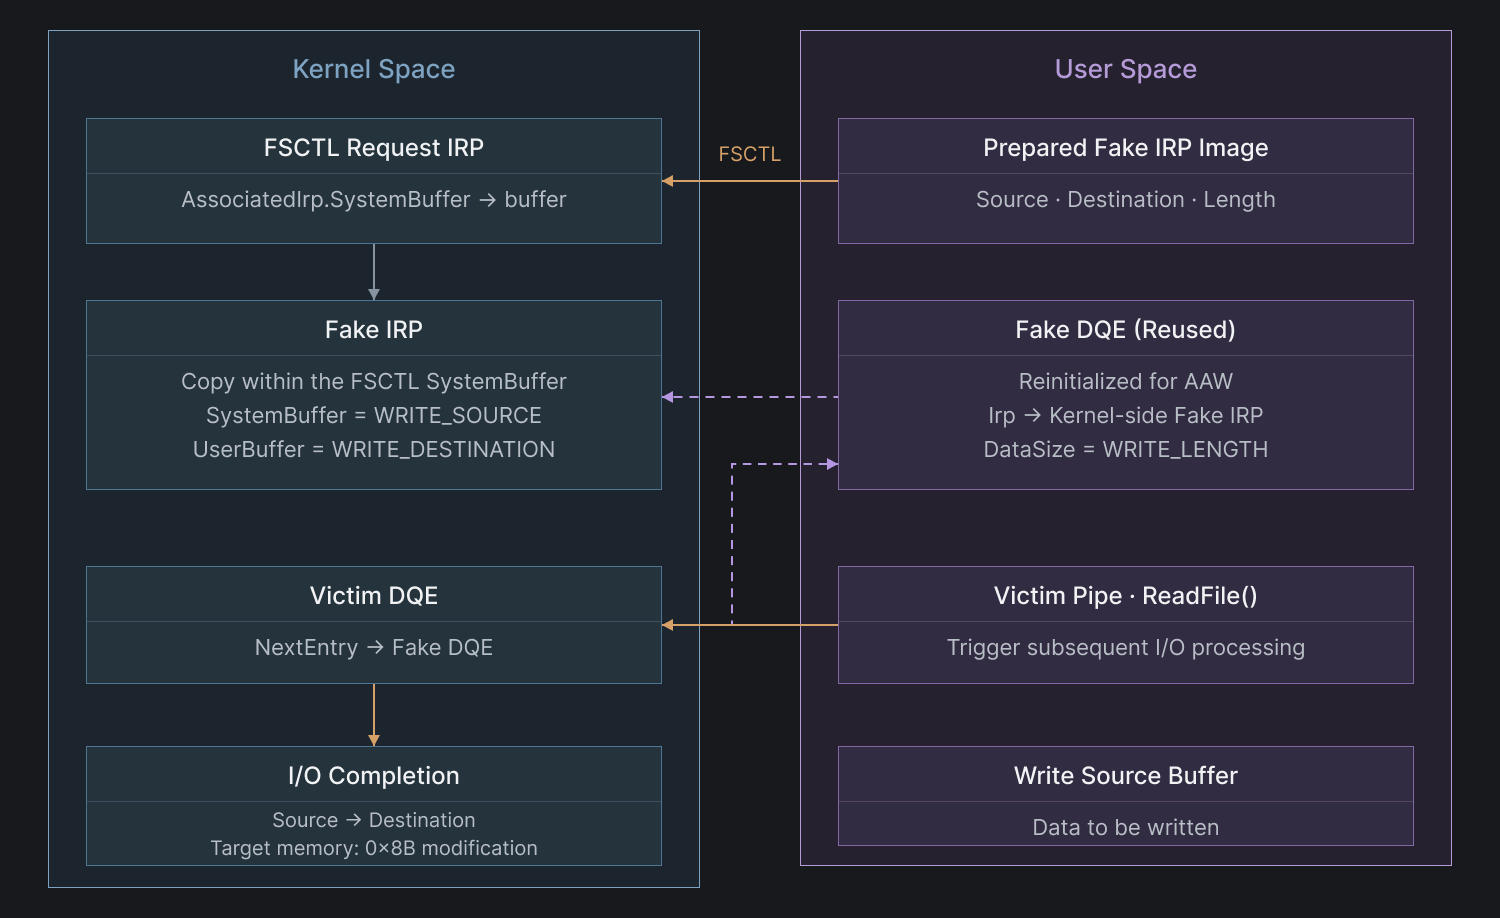
복잡해 보이지만, 핵심은 만든 Fake IRP를 Kernel 영역에 넣는다는 것입니다. Pending IRP의 정보를 AAR로 읽어온 내용을 템플릿으로 사용하여 원하는 대로 Inner IRP를 조작한 내용이 있습니다. 이 영역은 아직 User 영역에 존재합니다. 하지만, 이 영역이 Kernel 영역에 존재해야만 나중에 Fake DQE가 참고할 수 있습니다. 이를 해주는 것이 NtFsControlFile() 함수입니다. 이 함수가 InputBuffer로 들어온 Fake IRP 내용을 Kernel 영역인 AssociatedIrp.SystemBuffer로 옮겨줍니다. 즉, 우리가 만든 Fake IRP가 이제 Kernel 영역에 존재할 수 있게 되었습니다!
FakeIRP.AssociatedIrp.SystemBuffer = WRITE_SOURCE;
FakeIRP.UserBuffer = WRITE_DESTINATION;
FakeIRP.IoStatus.Information = WRITE_LENGTH;
Fake IRP는 AAW를 위해 위와 같이 세팅합니다. 이후, 위에서 설명한 과정을 거쳐 kernel에 위치시킵니다 그러나 Fake IRP가 준비되었다고 해서 Victim Pipe가 자동으로 이를 처리하는 것은 아닙니다. 이를 연결하기 위해 AAR에서 사용했던 Fake DQE를 다시 사용해줍니다.
FakeDQE = RESET_DQE_STATE;
FakeDQE.Irp       = InnerIRP;
FakeDQE.DataSize  = WRITE_LENGTH;
Victim Pipe에 대한 읽기 요청이 수행되면 NPFS는 Queue에 저장된 데이터와 I/O 요청의 상태에 따라 데이터를 처리합니다. 이 과정에서 IRP가 완료됩니다. 해당 IRP가 Buffered I/O Completion 경로를 사용하는 경우 I/O Manager가 AssociatedIrp.SystemBuffer에서 데이터를 가져와서 처리합니다.
// Pending IRP available
BOOL ok = ReadFile(
    victimPipe,
    &byte,
    1,
    &consumed,
    nullptr
);
Exploit은 ReadFile()의 데이터 이동을 이용해 AAW를 수행합니다. ReadFile()을 수행하면, 조작된 FakeDQE와 FakeIRP로 인해 AssociatedIrp.SystemBuffer가 나타내는 원본 데이터를 UserBuffer에 기록합니다.
4.6 Token Swapping
AAR과 AAW 프리미티브를 얻은 후에는 EPROCESS.Token 필드를 swapping 합니다.
AAR을 이용하여 현재 프로세스와 SYSTEM Process Token을 읽고, AAW로 현재 프로세스의 token을 덮어씁니다. 이를 통해 System 권한을 획득할 수 있습니다.
4.7 Cleanup
Overflow 이후 Victim DQE의 길이 정보와 Queue 연결 관계가 손상된 상태로 남아 있을 수 있습니다. 이러한 상태에서 파이프 객체의 해제나 Queue 정리가 진행되면 잘못된 메모리 참조, 메타데이터 검증 실패 또는 시스템 충돌이 발생할 가능성이 있습니다. 따라서 Exploit 이후에는 손상된 메타데이터와 관련 I/O 상태를 점검하고, 가능한 범위에서 자료구조의 일관성을 복구하는 과정이 필요합니다.
정상적인 Free와 Queue 정리를 위해서는 Allocator Metadata와 Named Pipe의 연결 상태가 일관되어야 합니다. AAR과 AAW로 Token Swapping이 완료된 후에는 조작했던 정보들을 원래대로 만듭니다. 이 과정이 존재해야 EoP 후, BSOD가 발생하지 않습니다.
5. 마무리
이번 글에서는 간단한 Windows Kernel Pool의 Allocation 구조와 VS Allocator의 동작을 분석하고 HEVD의 Nonpaged Pool Overflow를 이용한 Kernel Exploitation을 설명해보았습니다. 저에게도 Windows Kernel의 Pool과 관련되어 공부하는 좋은 기회가 되었습니다.
Kernel Pool은 계속해서 발전해나가고 변화하고 있기 때문에, 환경, 버전 등에 따라서 다른 결과가 나올 수 있습니다. 각자의 환경에 맞춰서 생각해주시면 좋을 것 같습니다.
긴 글 읽어주셔서 감사합니다!
Reference
- Windows Internals
- Inside Your Kernel — HEVD Nonpaged Pool Overflow
- Tarjei Mandt — Kernel Pool Exploitation on Windows 7
- Mark Vincent Yason — Windows 10 Segment Heap Internals
- Bayet & Fariello — Pool Overflow Exploitation Since Windows 10 19H1
- Yarden Shafir et al. — Windows Heap-Backed Pool
- Angelboy — Windows Kernel Heap: Segment Heap in Windows Kernel Part 1
- Rotce — Windows Kernel Heap Internals
- Kernullist — About Kernel Segment Heap
- Microsoft — ExAllocatePool2
- Microsoft — POOL_FLAGS
- HEVD — HackSys Extreme Vulnerable Driver
본 글은 CC BY-SA 4.0 라이선스로 배포됩니다. 공유 또는 변경 시 반드시 출처를 남겨주시기 바랍니다.