[하루한줄] CVE-2026-64560 : Linux Kernel POSIX CPU Timer의 non-leader exec() race condition으로 인한 Use-After-Free 취약점
Target
- Linux Kernel 5.1 <= version < 7.1.5
Explain
CVE-2026-64560은 Linux Kernel의 POSIX CPU timer 처리 과정에서 발생하는 race condition 기반 Use-After-Free(UAF) 취약점입니다. 취약점의 핵심은 non-leader thread가 execve()를 호출해 thread-group leader가 교체되는 과정과, POSIX CPU timer가 PID를 이용해 대상 task_struct를 조회하는 과정이 충돌하는 데 있습니다.
Background
CLOCK_PROCESS_CPUTIME_ID는 프로세스에 속한 모든 thread의 CPU 사용 시간을 기준으로 동작하는 clock입니다. POSIX CPU timer는 내부적으로 대상 PID를 보관하고, timer를 처리할 때 PID를 통해 task_struct를 찾은 뒤 sighand를 lock합니다.
아래 코드는 해당 흐름을 단순화한 것입니다.
p = pid_task(timer->it.cpu.pid, pid_type);
sighand = lock_task_sighand(p, &flags);
기존에는 POSIX CPU timer가 group leader의 task_struct를 직접 참조했습니다. 하지만 non-leader thread가 execve()를 실행하면 leader가 변경될 수 있어 문제가 있었습니다. 2010년 e0a70217107e 커밋에서 임시 workaround가 적용됐고, 이후 Linux 5.7의 55e8c8eb2c7b 커밋에서 timer가 task_struct 대신 struct pid를 저장하도록 변경되었습니다. 하지만 이 패치로 PID lookup과 sighand lock 사이의 race condition이 발생하였습니다.
Root Cause
multi-threaded 프로세스에서 non-leader thread가 execve()를 호출하면 de_thread()를 거쳐 기존 leader가 제거되고, execve()를 호출한 thread가 새로운 leader가 됩니다. 이때 leader는 변경되지만 TGID 자체는 유지됩니다. 때문에 TGID를 대상으로 하는 CLOCK_PROCESS_CPUTIME_ID timer는 execve() 이후에도 process timer queue에 남아있을 수 있습니다.
문제는 이 leader 교체 과정과 timer_delete()가 동시에 수행될 때 발생합니다.
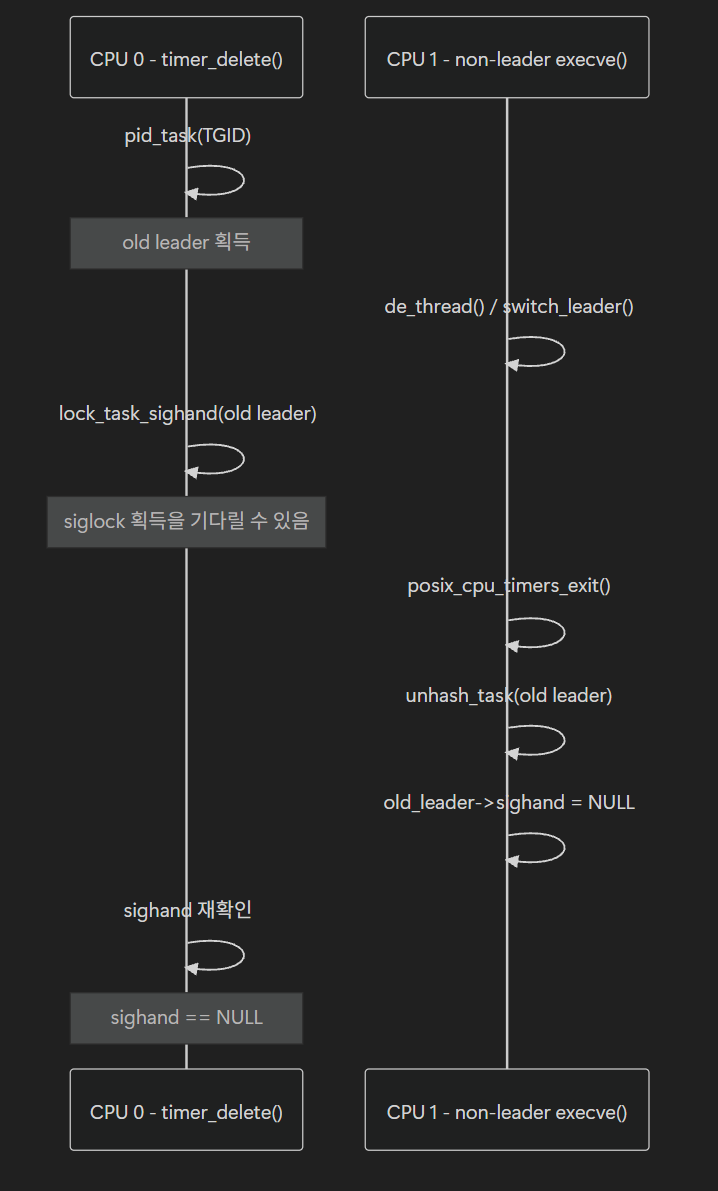
CPU 0은 pid_task()에서 old leader의 task_struct를 가져옵니다. 이후 CPU 1에서 leader 교체가 진행되면 CPU 0은 이미 제거 중인 old leader를 계속 참조하게 됩니다. lock_task_sighand() 호출 시 CPU 1이 siglock을 보유하고 있다면 대기할 수도 있으며, 이후 sighand를 다시 확인했을 때 NULL을 관찰하게 됩니다.
기존 posix_cpu_timer_del()은 이를 일반적인 task exit와 동일하게 처리했습니다. 아래 코드는 관련 부분을 단순화한 것입니다.
p = cpu_timer_task_rcu(timer);
sighand = lock_task_sighand(p, &flags);

if (!sighand) {
    /* exit 과정에서 timer가 이미 dequeue됐다고 가정 */
    WARN_ON_ONCE(ctmr->head ||
                 timerqueue_node_queued(&ctmr->node));
    goto out;
}
일반적인 process exit라면 해당 가정이 맞지만 non-leader execve()에서는 thread group 자체가 종료되는 것이 아니기 때문에 TGID 기반 process timer가 새로운 leader에 그대로 유지될 수 있습니다.
결과적으로 timer queue에는 node가 남아있지만, timer_delete()에서는 삭제가 완료된 것으로 판단해 k_itimer를 해제할 수 있습니다.
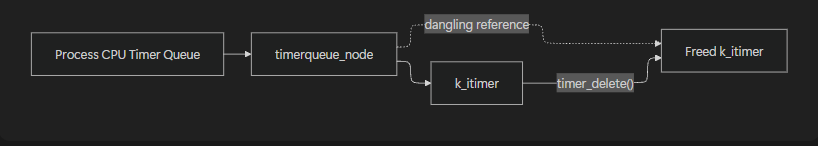
이후 run_posix_cpu_timers() 또는 다른 timer의 add/delete 과정에서 이미 해제된 k_itimer의 timerqueue node를 다시 참조하면 UAF가 발생합니다.
같은 race는 다른 CPU timer 경로에도 영향을 줍니다.
posix_cpu_timer_del()- queue에 남아있는
k_itimer가 해제되어 UAF가 발생할 수 있습니다.
- queue에 남아있는
posix_cpu_timer_set()- 일반 timer에서는 일시적으로
ESRCH가 반환될 수 있습니다. do_cpu_nanosleep()에서는 stack에 할당된k_itimer가 영향을 받아 UAF로 이어질 수 있으며,clock_nanosleep()도 관련 경로에 포함됩니다.
- 일반 timer에서는 일시적으로
posix_cpu_timer_rearm()- rearm이 무시되어 timer가 다시 expire하지 않는 문제가 발생할 수 있습니다.
Patch
패치는 PID lookup과 sighand lock을 묶은 helper인 timer_lock_sighand()를 추가하고, 이를 posix_cpu_timer_del() / posix_cpu_timer_set() / posix_cpu_timer_rearm()에 적용했습니다. 패치 적용 후 코드 흐름은 아래와 같습니다.
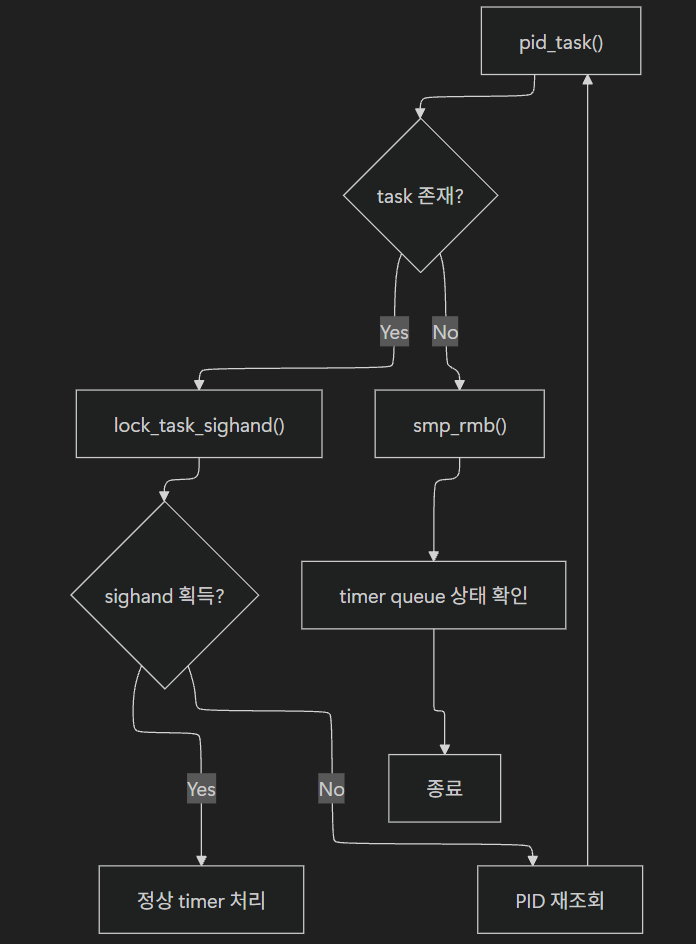
CPU 0가 old leader의 sighand == NULL을 확인했다고 하더라도, 다른 CPU에서 그 전에 수행한 leader 제거 작업까지 확실하게 반영된 상태여야 합니다. 그렇지 않으면 PID를 다시 조회했을 때 아직 old leader를 바라볼 가능성이 생깁니다. 이를 막기 위해 sighand를 NULL로 변경하는 쪽과 이를 확인하는 쪽에 memory ordering을 추가했습니다.
- tsk->sighand = NULL;
+ smp_store_release(&tsk->sighand, NULL);
if (unlikely(sighand == NULL)) {
+ smp_acquire__after_ctrl_dep();
break;
}CPU 0가 sighand가 NULL이 됐다는 것을 확인했다면 CPU 1이 그보다 앞서 수행한 old leader 제거 작업도 함께 반영된 상태라고 볼 수 있도록 만들어 이후 PID를 다시 조회하면 non-leader execve() 상황에서는 old leader가 아니라 새로운 leader를 가져올 수 있습니다.
다만 처음부터 pid_task()가 실패한 경우에는 lock_task_sighand()를 실행하지 않으므로 위와 같은 확인 과정을 거치지 않습니다. 이 경우에는 timer cleanup 결과가 제대로 반영됐는지 확인하기 위해 별도의 smp_rmb()가 사용됩니다.
smp_rmb();

WARN_ON_ONCE(ctmr->head ||
             timerqueue_node_queued(&ctmr->node));
여기서 WARN 조건 자체가 새롭게 변경되지는 않고 기존 posix_cpu_timer_del()에서도 동일한 조건을 사용했습니다. 패치에서는 해당 검사를 timer_lock_sighand()의 PID lookup 실패 경로로 옮기고, 그 전에 smp_rmb()를 추가해 timer cleanup 결과가 반영된 뒤 queue 상태를 확인하도록 변경했습니다.
Reference
본 글은 CC BY-SA 4.0 라이선스로 배포됩니다. 공유 또는 변경 시 반드시 출처를 남겨주시기 바랍니다.